Собрать демо «чат по документам» можно за вечер. Дальше поиск приносит не тот раздел, агент отвечает по отменённому регламенту, а стало ли лучше после правки, никто не знает. В курсе вы собираете retrieval для LLM и агентов на своём стеке: Qdrant и pgvector. На скрытом наборе вопросов вы поднимаете recall@5 с 0,45 до цели. 12 модулей, 46 лабораторных, практика в браузере.
На своём корпусе демо быстро ломается. Поиск приносит соседний раздел вместо нужного. Ответ ссылается на регламент, отменённый полгода назад. Таблицу с лимитами нарезка разорвала пополам, и модель складывает числа из разных строк. А стало ли лучше после правки, сказать нельзя: качество никто не мерил.
Потом выясняется, что закрытые документы видят все. Что в базу знаний можно положить файл с инструкцией для модели, и она её выполнит. И что кэш отдаёт одному пользователю ответ, собранный по чужим документам.
Этим и занимается курс. Каждый компонент вы пишете сами и сразу проверяете числами: что нашлось, на каком месте и насколько ответ опирается на найденное.
Корпус компании весит гигабайты и меняется каждый день, а миллион токенов в каждом запросе стоит дорого и отвечает медленно. Кэширование промпта снижает цену, но не решает свежесть, права доступа и цитаты. Какие десять фрагментов из ста тысяч документов увидит модель, всё равно кто-то решает. Это и есть retrieval.
Агент работает через инструменты, и главный из них поиск. Если поиск приносит не то, агент ошибается, и правкой промпта это не лечится.
Готовый file search у провайдеров удобен, пока не нужно разобраться, почему нашёлся не тот документ, и пока не нужны права доступа ваших пользователей. А документы компании часто нельзя отдавать наружу, поэтому весь стек курса свой: Qdrant, pgvector, BM25.
Задания похожи на инженерную работу. Базовый конвейер (fixed-512 и только векторный поиск) находит нужный документ в первой пятёрке меньше чем у половины вопросов: recall@5 = 0,45. Одна смена нарезки на md_aware поднимает его до 0,75, а на вопросах по таблицам BM25 даёт 0,94 против 0,48 у векторного поиска. Дальше вы добавляете гибридный поиск и реранкер и доводите метрику до цели, которую задаёт эталонное решение. 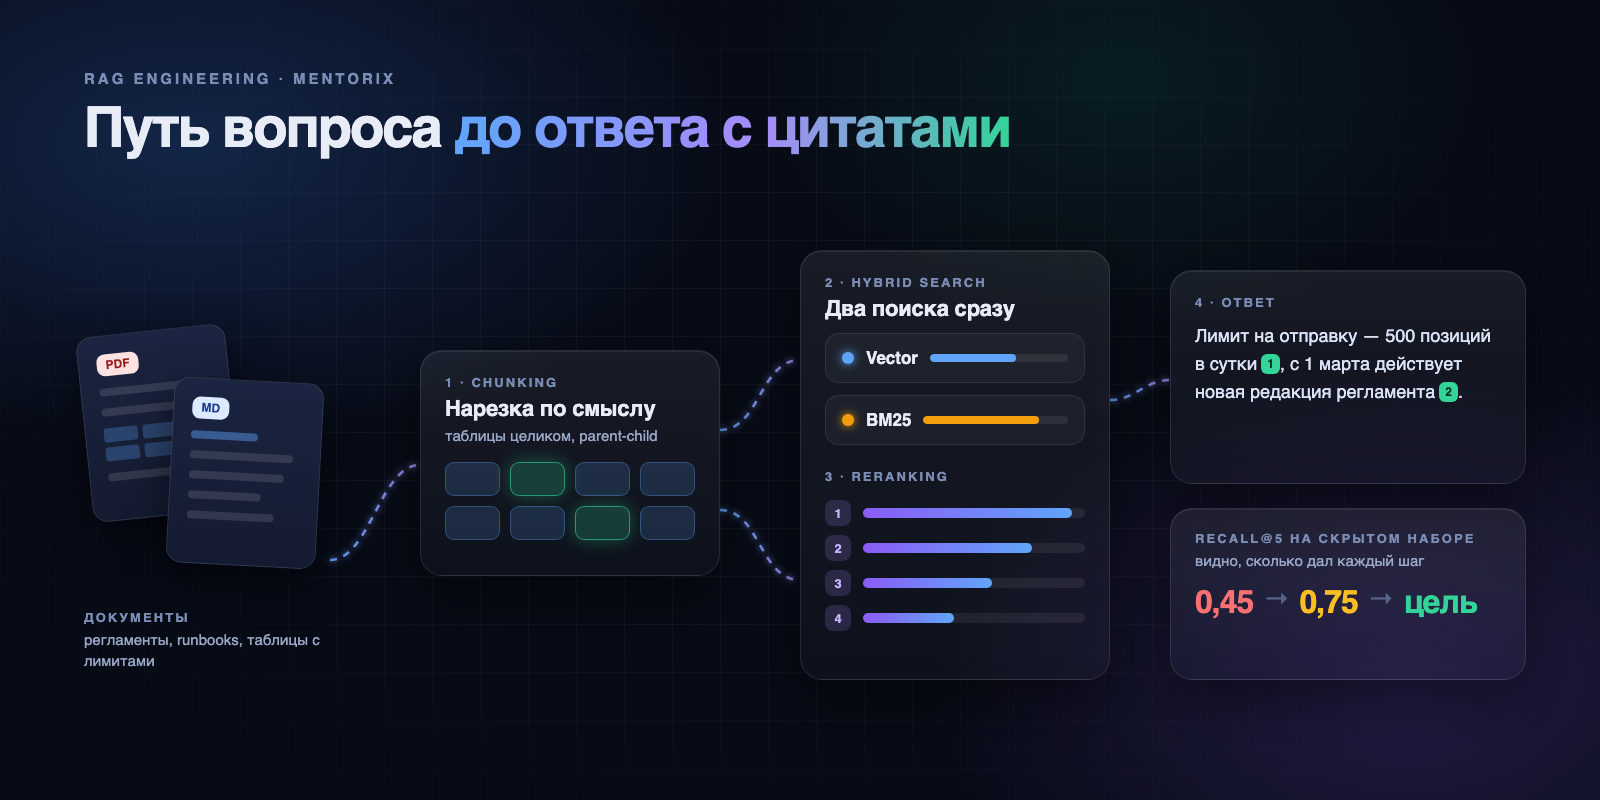
Метрика считается на скрытом наборе вопросов, так что подогнать решение под проверку нельзя: ваш вывод проверка не читает, она считает сама. Ещё она смотрит журнал вызовов модели, состояние индекса и права доступа, то есть проверяет, как система себя ведёт.
Работать вы будете с внутренней документацией вымышленной B2B-платформы для логистики «Ортус»: описания продукта, runbooks, регламенты, тарифы. Внутри есть таблицы с лимитами, устаревшие редакции без пометок и похожие документы, которые легко перепутать.
Qdrant, PostgreSQL с pgvector, BM25, парсинг PDF, MCP, OpenTelemetry и FastAPI работают в браузерной песочнице. Эмбеддинги (e5-small) и реранкер (bge-reranker-base) настоящие. Генеративную модель заменяет детерминированный сервер с тем же контрактом, что у OpenAI, а судью для оценки ответов — отдельный детерминированный сервер. Так результат воспроизводим, и платить за токены не нужно. Первые три урока открыты бесплатно, в каждом есть задача на код.
В финале вы собираете production agentic RAG: загрузка документов с правами доступа, гибридные индексы, агентный цикл с цитатами к каждому утверждению, проверки с порогами качества и обновление корпуса, в который подложены отравленные документы. Систему принимают в четырёх режимах: ответы на вопросы, атаки, переиндексация и трассировка.
Первая половина курса строит сам конвейер. Вторая про то, чего нет в туториалах: продвинутые схемы поиска, GraphRAG, агентный цикл, MCP, продакшен, безопасность и стоимость. Если вы уже собирали RAG, новое для вас начнётся там.
Вопросы по курсу можно задать поддержке: t.me/mentorix_support
Вам поручили «сделай поиск и ответы по нашим документам», и отвечать за результат будете вы.
Вы собрали демо на LangChain или LlamaIndex и хотите понимать, что происходит под ним.
RAG уже работает, но качество никто не измеряет, и после каждой правки непонятно, стало лучше или хуже.
Вы строите агентов и хотите дать им поиск через MCP, не открыв лишнего.
Вы отвечаете за закрытые документы: права доступа, устаревшие редакции, инъекции.
Python: функции, классы, работа с файлами и JSON.
HTTP на уровне запросов и кодов ответа, SQL на уровне SELECT и JOIN.
ML-бэкграунд не нужен: эмбеддинги, метрики и простую модель ранжирования разбираем по ходу.
Обучение и дообучение больших моделей здесь не разбирается, это темы курсов ML-инженера и MLOps.
Модулей: 12, уроков: 61. Задачи с кодом проверяются автоматически.
Стоимость курса: 12990 ₽